
स्वचालित पाठ सारांश – लिंकन, स्वचालित सारांश का परिचय – डेटा ब्लॉग
डेटा, आर्टिफिशियल इंटेलिजेंस और मेरी प्रोजेक्ट्स पर एक ब्लॉग
स्वचालित सारांश एक लंबा पाठ, या यहां तक कि ग्रंथों का एक सेट लेना है, और स्वचालित रूप से एक बहुत छोटा पाठ उत्पन्न करना है जिसमें अधिकांश जानकारी शामिल है. सरल ? इतना भी नहीं. सबसे पहले, आपको सहमत होना होगा कि क्या जानकारी वास्तव में महत्वपूर्ण है. फिर, हमें उन्हें ठीक से निकालने में सक्षम होना चाहिए, उन्हें पुनर्गठित करना चाहिए, सभी एक व्याकरणिक पाठ में और मानव हस्तक्षेप के बिना. और यह संभावित सारांशों के वेरिएंट की बड़ी संख्या पर गिनती के बिना है !
स्वत: पाठ सारांश
बनावट संग्रह और भंडारण के विस्फोट के साथ, इस द्रव्यमान से प्रासंगिक जानकारी का विश्लेषण और निकालने की आवश्यकता अधिक से अधिक मौजूद है.
इसके अलावा, बूम इन डीप लर्निंग मॉडल फॉर ऑटोमैटिक नेचुरल लैंग्वेज प्रोसेसिंग (TALN) ने परिचालन मुद्दों में पाठ डेटा के उपयोग की सुविधा प्रदान की. स्वचालित पाठ सारांश, उसी तरह से उत्तर देने वाले प्रश्न, समानता विश्लेषण, दस्तावेज़ का वर्गीकरण और TALN से जुड़े अन्य कार्य इन मुद्दों का हिस्सा हैं.
यह इस संदर्भ में है कि लैब इनोवेशन डी लिंकन ने स्वचालित पाठ सारांश पर काम करने का फैसला किया है. इन कार्यों ने भाषा के लिए उपलब्ध स्वचालित सारांश मॉडल का एक बेंचमार्क स्थापित करना संभव बना दिया है फ्रांसीसी, हमारे अपने मॉडल का कारण बनें और अंत में इसे उत्पादन में डाल दें.
�� मॉडल प्रशिक्षण
डेटा
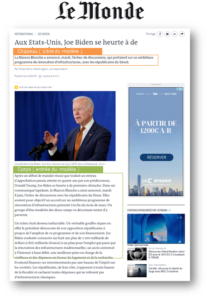
इससे पहले कि हम अपना काम शुरू कर सकें, हमें पहले स्वचालित सारांश मॉडल सीखने के लिए एक डेटाबेस का निर्माण करना था. हमने कई फ्रांसीसी समाचार साइटों से प्रेस आइटम बरामद किए हैं. इस आधार में ~ 60k लेख हैं और लगातार अपडेट किया जाता है.
आधुनिकतम
स्वचालित सारांश एल्गोरिदम को दो श्रेणियों में अलग किया जा सकता है: सारांश निष्कर्षण और सारांश भावात्मक. चौखट में निष्कर्षण, सारांश पाठ से निकाले गए वाक्यों से बनाए गए हैं जबकि सारांश भावात्मक नए वाक्यों से उत्पन्न होते हैं.
स्वचालित सारांश मॉडल अंग्रेजी में काफी आम हैं, लेकिन वे फ्रेंच में बहुत कम हैं.
मेट्रिक्स
मॉडलों के मूल्यांकन के लिए हमने निम्नलिखित मैट्रिक्स का उपयोग किया:
लाल : निस्संदेह माप सबसे अधिक बार सारांश कार्यों में रिपोर्ट किया गया था, रिकॉल ओरिएंटेड अंडरस्टोडिंग फॉर गिस्टिंग इवैल्यूएशन (लिन, 2004) मूल्यांकन किए गए सारांश और मानव संदर्भ सारांश के बीच समान एन-ग्राम की संख्या की गणना करता है.
उल्का: स्पष्ट आदेश के साथ अनुवाद के मूल्यांकन के लिए मीट्रिक (बनर्जी और लवी, 2005) को स्वचालित अनुवाद परिणामों के मूल्यांकन के लिए डिज़ाइन किया गया था. यह सटीकता के हार्मोनिक औसत पर आधारित है और यूनीग्राम पर याद करता है, रिकॉल में सटीक से अधिक भार होता है. उल्का का उपयोग अक्सर स्वचालित सारांश प्रकाशनों में किया जाता है (एट अल देखें., 2017; डोंग एट अल., 2019), लाल के अलावा.
नवीनता: यह देखा गया है कि कुछ अमूर्त मॉडल निष्कर्षण पर बहुत अधिक आराम करते हैं (एट अल देखें)., 2017; Krysci et nski et al.‘, 2018). इसलिए, उत्पन्न सारांश के भीतर उत्पादित नए एन-ग्राम के प्रतिशत को मापना आम हो गया है.
स्रोत: mlsum पेपर से अनुवाद [2].
मॉडल की तैनाती
मॉडल प्रशिक्षण के लिए, हमने क्लाउड एज़्योर एमएल सेवा का उपयोग किया जो मॉडल के प्रशिक्षण, निगरानी और तैनाती के लिए एक पूर्ण वातावरण प्रदान करता है.
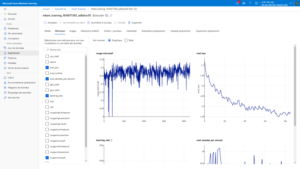
हमने अधिक सटीक रूप से पायथन एसडीके का उपयोग किया है जो आपको “नौकरियों” के लॉन्च से लेकर मॉडलों की तैनाती तक, पूरे एज़रेम्ल वातावरण को एक प्रोग्रामेटिक तरीके से प्रबंधित करने की अनुमति देता है।.
हालांकि, हमने अपने अंतिम मॉडल को एक कंटेनरीकृत फ्लास्क एप्लिकेशन में एनकैप्सुलेट किया, फिर एक कुबेरनेट्स क्लस्टर पर सीआई/सीडी पाइपलाइनों के माध्यम से तैनात किया गया
परिणाम
सबसे पहले, हमने कई प्रयास किए, 10K लेखों पर मॉडल का नेतृत्व किया, मॉडल की शुरुआत (512 या 1024) और विभिन्न आर्किटेक्चर की शुरुआत में दिए गए टोकन की संख्या को अलग -अलग किया.
पहला अवलोकन: लाल और उल्का मैट्रिक्स हमारे मॉडल के प्रदर्शन मूल्यांकन के लिए बहुत उपयुक्त नहीं लगते हैं. इसलिए हमने केवल नवीनता स्कोर पर अपनी तुलना को आधार बनाने के लिए चुना और चयनित किया वास्तुकला अधिक अमूर्त सारांश के पक्ष में.
700K आइटम पर हमारे मॉडल के प्रशिक्षण को आगे बढ़ाने के बाद, हमने परिणामों में काफी सुधार किया और एक पहले संस्करण को मान्य किया जो आपको नीचे मिलेगा.
ध्यान अंक
प्रदर्शन से परे, इस प्रयोग ने हमें कुछ को उजागर करने की अनुमति दी सीमाएँ स्वचालित सारांश:
वर्तमान में, प्रकार के मॉडल के इनपुट में पाठ का आकार परिवर्तन GPU की स्मृति में क्षमता से सीमित है. मेमोरी में लागत इनपुट के रूप में पाठ के आकार के साथ द्विघात हो रही है, यह स्वचालित सारांश के कार्यों के लिए एक वास्तविक समस्या है जहां संक्षेप को संक्षेप में किया जाना अक्सर काफी लंबा होता है.
पाठ उत्पादन कार्यों का आकलन करने के लिए प्रासंगिक मैट्रिक्स ढूंढना बहुत मुश्किल है.
ध्यान से चिमटा का वजन : हमने अपने आप में डेटा से संबंधित कई समस्याओं का भी सामना किया है. मुख्य समस्या यह है कि लेख का लेख अक्सर एक विरोधाभास था या यहां तक कि लेख के पहले वाक्यों का एक डुप्लिकेट भी था. यह हमारे मॉडलों को प्रोत्साहित करने का परिणाम था जो केवल लेख के पहले वाक्यों को वापस करके अमूर्त से अधिक निकालने के लिए अधिक निकालने के लिए था. इसलिए इस तरह के पूर्वाग्रह से बचने के लिए समस्या को हटाने के लिए एक क्यूरेशन कार्य करना आवश्यक था.
डेटा, आर्टिफिशियल इंटेलिजेंस और मेरी प्रोजेक्ट्स पर एक ब्लॉग.
स्वचालित सारांश एक लंबा पाठ, या यहां तक कि ग्रंथों का एक सेट लेना है, और स्वचालित रूप से एक बहुत छोटा पाठ उत्पन्न करना है जिसमें अधिकांश जानकारी शामिल है. सरल ? इतना भी नहीं. सबसे पहले, आपको सहमत होना होगा कि क्या जानकारी वास्तव में महत्वपूर्ण है. फिर, हमें उन्हें ठीक से निकालने में सक्षम होना चाहिए, उन्हें पुनर्गठित करना चाहिए, सभी एक व्याकरणिक पाठ में और मानव हस्तक्षेप के बिना. और यह संभावित सारांशों के वेरिएंट की बड़ी संख्या पर गिनती के बिना है !
मैं अपने डॉक्टरेट से ठीक पहले इस रोमांचक विषय पर लगभग एक साल तक काम करने में सक्षम था, इसलिए यह पोस्ट मेरे लिए इस विषय में खुद को डुबोने और डोमेन में नवीनतम नवाचारों का जायजा लेने का अवसर है.
तो आइए इस विषय का अवलोकन करें, विभिन्न प्रकार के सारांशों का वर्णन करके, जो मौजूद हैं, दो प्रकार की प्रणालियों पर थोड़ा विस्तार से रहने से पहले: एआई और तंत्रिका नेटवर्क से, और जो कि इष्टतम निष्कर्षण पर केंद्रित हैं। जानकारी.
विभिन्न प्रकार के सारांश
जब हम सारांश के बारे में बात करते हैं, तो हम अक्सर किसी पुस्तक के पीछे के कवर या किसी फिल्म के लिए स्क्रिप्ट का वर्णन सोचते हैं. आम तौर पर, वे अंत को खराब करने से बचते हैं, जब यह ठीक है कि कोई भी क्लासिक स्वचालित सारांश के एक उपकरण के लिए क्या पूछेगा: साज़िश को बताने के लिए, ताकि सारांश आवश्यक जानने के लिए पर्याप्त हो. यहाँ के बारे में है मोनो-दस्तावेज़ सारांश, यह कहना है कि हम केवल एक ही दस्तावेज़ (एक फिल्म, एक पुस्तक, एक लेख, …) को संक्षेप में प्रस्तुत करते हैं.
इसके विपरीत, हम एक चाहते हैं बहु-वृत्तचित्र सारांश, हम प्रेस समीक्षाओं के संदर्भ में अधिक बार मिलते हैं: हम चाहते हैं कि विभिन्न प्रेस संगठनों द्वारा रिपोर्ट की गई सबसे महत्वपूर्ण जानकारी का सारांश हो.
एक बार जब हमने डेटा के प्रकार के बारे में तय कर लिया है, जिसे हम संक्षेप में प्रस्तुत करना चाहते हैं, तो मोनो या मल्टी-डॉक्यूमेंट्री, हमारे पास दो दृष्टिकोणों के बीच विकल्प है:निष्कर्षण, जिसमें एक सारांश बनाने के लिए वापस डालने से पहले जानकारी के रूप में क्या निकालने में शामिल है, और दृष्टिकोण उत्पादक, जिसमें नए वाक्य बनाने में शामिल हैं, जो मूल रूप से दस्तावेजों में दिखाई नहीं देते हैं, ताकि अधिक तरल और स्वतंत्र सारांश हो सके.
इन मानदंडों के अलावा, सारांशों की विभिन्न शैलियाँ हैं, जिन्हें हम यहां नहीं देखेंगे: अद्यतन सारांश जो एक नए दस्तावेज़ में प्रदर्शित होने वाली जानकारी को संक्षेप में शामिल करते हैं और जिसे अब तक सूचीबद्ध नहीं किया गया था, संक्षेप में निर्देशित किया गया है जो एक सटीक कोण को अपनाने में शामिल है। उपयोगकर्ता द्वारा दिया गया, ..
एआई और तंत्रिका नेटवर्क स्वचालित सारांश में क्रांति लाएं
मध्य -2010 के दशक तक, अधिकांश सारांश निकाले गए थे. हालांकि, इन एल्गोरिदम में पहले से ही महान विविधता मौजूद थी, जो पूरे वाक्यों के चयन और निष्कर्षण से लेकर सटीक जानकारी के निष्कर्षण तक हो सकती है, फिर बाद में तैयार किए गए छेदों के साथ ग्रंथों में टेम्प्लेट कहा जाता है।. तंत्रिका नेटवर्क पर आधारित नए दृष्टिकोणों के आगमन ने स्थिति को काफी बदल दिया है. ये एल्गोरिदम व्याकरणिक और द्रव पाठ उत्पन्न करने के लिए पिछले वाले की तुलना में बहुत अधिक प्रभावी हैं, जैसे कि इस जीपीटी डेमो के साथ क्या किया जा सकता है.
तंत्रिका नेटवर्क, हालांकि, बड़ी मात्रा में डेटा को प्रशिक्षित करने की आवश्यकता होती है और अपेक्षाकृत अशुद्ध होते हैं. वे पूरी तरह से उन टिप्पणियों को उत्पन्न करने के लिए काम करते हैं, जिनके लिए सत्यता का बहुत कम महत्व है, लेकिन दृढ़ता से विरोधाभासी या केवल गलत जानकारी उत्पन्न हो सकती है जो उदाहरण के लिए प्रेस लेख सारांश के संदर्भ में समस्याग्रस्त है. कई शोध लेख तंत्रिका नेटवर्क के इन “मतिभ्रम” में रुचि रखते हैं.
एक हाइब्रिड टूल का एक उदाहरण: पोटारा
स्वचालित सारांश पहला शोध विषय था जिसमें मुझे दिलचस्पी थी, और मुझे अपने मास्टर के दौरान एक बहु-दस्तावेज़ दृष्टिकोण के लिए निष्कर्षण/पीढ़ी द्वारा सारांश की एक हाइब्रिड सिस्टम के दौरान विकसित करने का अवसर मिला, जो यह कहना है कि दस्तावेज बोलने के एक सेट को संक्षेप में प्रस्तुत करना है उसी विषय का.
यह विचार एक क्लासिक निष्कर्षण से शुरू करने के लिए था, अर्थात् सबसे महत्वपूर्ण वाक्यों की पहचान करने और उन्हें एक सारांश उत्पन्न करने के लिए उन्हें इकट्ठा करने के लिए. इस दृष्टिकोण के साथ समस्या यह है कि सबसे महत्वपूर्ण वाक्यों को अक्सर और सुधार किया जा सकता है. उदाहरण के लिए, एक राष्ट्रपति के विस्थापन के एक लेख में, “इमैनुएल मैक्रॉन ने अपने अमेरिकी समकक्ष से मुलाकात की और अर्थशास्त्र पर चर्चा की” वाक्यांश “इमैनुएल मैक्रॉन ने जो बिडेन से मेट और चर्चा की जा सकती है” में सुधार किया जा सकता है “. पत्रकारों को ध्यान से पूर्वाभ्यास से बचते हुए, हम अपने आप को अक्सर इस तरह की घटना के साथ सामना करते हैं.
इस दोष को दूर करने के लिए, हम विभिन्न दस्तावेजों में मौजूद समान वाक्यों की पहचान कर सकते हैं और एक बेहतर वाक्य प्राप्त करने के लिए उन्हें मर्ज करने का प्रयास कर सकते हैं. ANSI, निम्नलिखित दो वाक्यों से:
- इमैनुएल मैक्रॉन ने वाशिंगटन में अपने अमेरिकी समकक्ष से मुलाकात की और लंबाई में अर्थशास्त्र के बारे में बात की.
- फ्रांसीसी राष्ट्रपति ने जो बिडेन से मुलाकात की और अर्थशास्त्र पर चर्चा की.
हम एक छोटा और जानकारीपूर्ण वाक्य बना सकते हैं:
- इमैनुएल मैक्रॉन ने वाशिंगटन में जो बिडेन से मुलाकात की और अर्थशास्त्र पर चर्चा की.
इस परिणाम को प्राप्त करने के लिए कई कदम आवश्यक हैं: समान वाक्य ढूंढना, सबसे अच्छा संलयन ढूंढना, उस संलयन की जाँच करना एक मूल वाक्य की तुलना में बहुत बेहतर है. वे कई प्रौद्योगिकियों का हिस्सा लेते हैं: वर्ड 2 तंत्रिका नेटवर्क के साथ इसी तरह के वाक्य खोजने के लिए, उन्हें मर्ज करने के लिए सह-संयोग रेखांकन, सबसे अच्छा विलय का चयन करने के लिए ILP अनुकूलन.
यदि आप अधिक देखना चाहते हैं, तो पोटारा ओपन-सोर्स है, लेकिन थोड़ी देर के लिए बनाए नहीं रखा गया है. इस परियोजना ने उल्लेखनीय रूप से एक शोकेस के रूप में कार्य किया था जब मुझे रिलीज़ किया गया था और इसलिए इसमें प्रलेखन, परीक्षण, निरंतर एकीकरण, PYPI पर तैनाती थी, ..
एक अच्छा स्वचालित सारांश क्या है ?
यदि कुछ मानदंड स्पष्ट और अपेक्षाकृत सरल लगते हैं (उदाहरण के लिए वाक्यों की व्याकरणिकता), अन्य बहुत अधिक जटिल हैं. यह तय करना कि किसी पाठ की सबसे महत्वपूर्ण जानकारी पहले से ही अपने आप में एक बहुत ही व्यक्तिपरक कार्य है. तरलता का मूल्यांकन करें, उपयोग किए गए शब्दों का सही विकल्प, प्रकाशन कार्य पर वापस आता है, और चलो राजनीतिक अभिविन्यास के बारे में बात नहीं करते हैं कि एक सारांश ले सकता है !
तंत्रिका नेटवर्क पर आधारित नए जनरेटिव मॉडल में pejorative निर्णय या क्वालीफायर (या उपयोगकर्ता -मित्र) को पेश करने की संभावना है, एक प्रभाव मांगा जब यह एक फिल्म आलोचक उत्पन्न करने की बात आती है, लेकिन राष्ट्रपति पद के उम्मीदवार के कार्यक्रम के बारे में बात करते समय बहुत कम !
स्वचालित सारांश इसलिए अनुसंधान में एक बहुत सक्रिय विषय बना हुआ है, और एक पल के लिए हो सकता है, विशेष रूप से एल्गोरिथ्म के परिणाम को निर्देशित करने की क्षमता के संबंध में, एक विशेष भावना, एक विशिष्ट शैली, एक राजनीतिक रंग दिया गया. उद्योग में, वह अभी बहुत विशिष्ट अधिकारियों में प्रवेश करना शुरू करता है (उदाहरण के लिए बैठकों का सारांश).
राष्ट्रपति 2022: अपने डेटा के लिए !
2022 के राष्ट्रपति चुनावों के लिए किए जाने वाले डेटा परियोजनाओं के 3 उदाहरण.